테마 전환
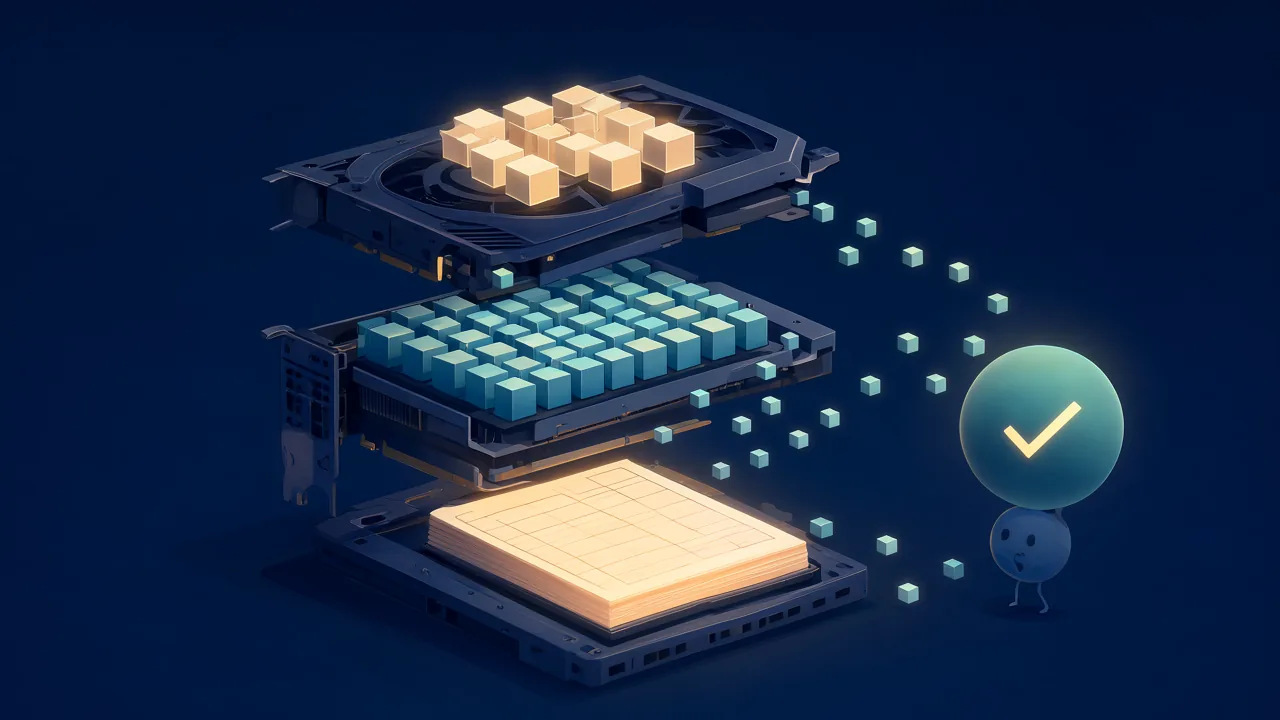
Qwen3.8-Flash-Next 같은 모델은 원래 서버용 그래픽 메모리 수백 GB에서 도는 초대형 MoE 모델입니다. 일반 그래픽 카드는 12~24GB. Strata는 "모델 전체를 한 곳에 얹지 않고 PC 전체로 일을 나누는" 방식으로 이 간극을 메웁니다. 공식 문서 HOW_IT_WORKS.md의 설명을 따라가 봅니다.
부엌 비유: 카운터, 팬트리, 창고
공식 문서에서는 이 복잡한 과정을 부엌에 비유해 쉽게 설명합니다. 자주 쓰는 도구는 조리대(카운터, 그래픽 카드)에 두고, 가끔 쓰는 재료는 팬트리(RAM)에, 아주 가끔 꺼내는 큰 도구는 창고(SSD)에 보관하는 식입니다.
- 모델은 24,576개의 작은 전문가(expert) 팀으로 이루어져 있고, 한 단어를 생성할 때 실제로는 그중 10개만 사용합니다. 즉, 모든 전문가를 굳이 그래픽 카드에 다 올릴 필요가 없다는 뜻입니다.
- 그래픽 카드에는 모든 단어에 공통적으로 필요한 부분과, 사용 빈도가 가장 높은 수천 개의 전문가를 상주 시킵니다. 어떤 전문가가 자주 쓰이는지는 모델이 돌아가는 동안 실시간으로 학습하여 최적화합니다.
- RAM에는 모든 전문가를 올려 둡니다. 만약 그래픽 카드에 없는 전문가가 필요하면 CPU가 직접 계산을 수행하는데, 이때 그래픽 카드의 계산과 병렬로 진행하여 서로를 기다리며 멈추는 시간을 최소화합니다.
- SSD에는 약 28.8GB 규모의 n-gram 룩업 테이블이 저장되어 있으며, 토큰마다 필요한 부분만 빠르게 읽어 옵니다.
기술적으로는 이렇게 정리됩니다.
| 계층 | 내용 |
|---|---|
| GPU(VRAM) | attention·DeltaNet mixer, gated-residual 가중치, 라우터, 공유 전문가, 출력 헤드, MTP 초안 레이어, KV 캐시(64K부터는 자주 읽는 부분만 두고 나머지는 RAM에서 스트리밍), 남는 VRAM을 최다 사용 전문가로 채우는 전문가 캐시 |
| RAM | 24,576개 전문가 전체(pinned). 카드에 없는 전문가는 CPU가 제자리에서 계산(AVX-512/AVX2 커널, i-quant는 ggml 커널). RAM이 적고 카드가 크면 low-RAM 모드에서 카드가 못 올리는 것만 RAM에 둔다 |
| SSD | 28.8GB n-gram 테이블. 토큰당 몇 줄씩 OS 캐시를 통해 읽기 |
NVIDIA(CUDA)와 AMD(HIP) 모두 같은 엔진을 각 카드용으로 컴파일한 것이므로 동작이 동일합니다.
GPU·RAM·SSD의 실제 역할
여기서 주목할 점은 각 계층이 서로를 기다리며 멈춰 있는 '직렬 구조'가 아니라는 것입니다. GPU는 캐시된 전문가를 처리하고, CPU는 RAM에 있는 나머지 전문가를 동시에 처리하는 병렬 구조를 가집니다. 물론 SSD 속도가 느리면 전반적인 성능이 떨어지긴 합니다. 특히 VRAM이 적은(예: 12GB) 카드일수록 SSD와 CPU를 기다리는 시간이 상대적으로 늘어나기 때문입니다.
RAM 요구량의 기준도 명확합니다. 모델의 첫 샤드가 시작될 때 RAM에 로드되는데, Q2_0 양자화 기준으로 약 34GB가 필요합니다. 따라서 "RAM 용량 $\ge$ 전문가 전체 크기 + OS 기본 사용량(약 10GB)"가 안정적인 실행을 위한 최소 조건입니다. 두 번째 샤드(29GB 룩업 테이블)는 SSD에 머무르므로 RAM 계산에서는 제외됩니다. (Apple Silicon이나 Strix Halo 같은 통합 메모리 환경에서는 이 모든 것을 한 번에 계산합니다.)
전문가 캐시: 클수록 유리한 VRAM
Strata에서 VRAM은 "모델 전체가 들어가야 하는 크기"가 아니라 얼마나 많은 전문가를 태울 수 있는가의 문제입니다. 공식 문서의 산술이 이를 잘 보여줍니다.
- VRAM 1GB마다 전문가 약 700개가 추가로 들어갑니다.
- GPU에 올라간 전문가 하나 = CPU가 계산하지 않아도 되는 하나.
- 그래서 빠른 GPU보다 큰 GPU가 유리합니다. 대화 내용에 따라 캐시 구성이 달라지며, 같은 프롬프트라도 실행마다 카드 위 전문가가 달라져 답변이 미세하게 다를 수 있다고 문서에 명시되어 있습니다.
추측 복호화: 먼저 추측하고 한 번에 검증
두 번째 속도 기둥은 추측 복호화(speculative decoding)입니다. "추측한 뒤 검증한다"로 동작은 단순합니다.
- 모델 내장 MTP 레이어가 다음 최대 3토큰을 추측하고, 큰 모델이 48개 레이어를 한 번 훑으며 검증합니다. 통과한 만큼을 한꺼번에 확정하므로 한 스텝에 평균 2.4~3.2토큰이 나옵니다. 품질은 그대로고 답이 1.6~1.8배 빨리 옵니다(추측은 보조만 하고 최종 결정은 큰 모델이 하므로).
- Qwen3.8-Flash-Next에서는 DFlash2라는 별도 초안 모델도 선택 가능합니다(
--drafting dflash2, 1.2GB 추가 다운로드). - 답변이 컨텍스트를 반복할 때(코드 수정, 인용)는 prompt lookup이 이전 사본에서 최대 5토큰을 추측합니다. 실측 수용률과 비용을 계산해 이득인 곳에서만 써서, 코드 수정 시나리오에서 6~11% 빨라집니다.
DeepSeek V4.1-Flash에는 별개의 DSpark 초안 모델이 붙어, 실측으로 RTX 3060 머신이 6.1~6.7 → 8.2~8.7 tokens/s, R9700 머신이 약 31 → 55~69 tokens/s로 오른 기록이 있습니다(CPU가 6코어뿐인 RTX 5070 머신에서는 이득이 없어 --dspark auto가 초안을 안 올립니다).
긴 문서 읽기와 대화 캐시
- 큰 청크 prefill: 긴 텍스트를 최대 8,192토큰 단위로 읽어들이기 때문에 코드베이스·문서 전체를 1,000 tokens/s 이상으로 읽습니다. 현재 레이어의 attention이 도는 동안 다음 레이어의 전문가가 PCIe로 스트리밍됩니다.
- 대화 캐시: 첫 메시지 이후에는 새로 추가된 부분만 읽습니다. 후속 질문이 몇 초 만에 시작되는 이유입니다. 엔진이 붙든 대화를 파일로 저장·복원하는 세션 파일 기능도 있습니다(세션 API 편 참고).
크레딧과 라이선스
- 모델: Qwen 팀의 Qwen3.8-Flash-Next, ISTA-DASLab·Unsloth·UkisAI(Swift 1.5) 등의 압축 버전. 모델 파일은 각 모델 라이선스 적용.
- llama.cpp/ggml 일부(MIT)를 사용하며, 아이디어 출처로 Splash·ninfer·HyperQwen을 명시합니다.
- Strata 코드는 MIT. 다만
third_party/ggml(MIT), 웹 앱 폰트(SIL OFL 1.1), 실험적 속도 projections 벡터(Qwen Community License 1.0) 등 일부 파일은 별도 라이선스입니다.
이 원리들을 알고 나면 뒤의 모델 선택 편에서 "RAM이 아니라 전문가 크기를 본다", 튜닝 편에서 "VRAM 예약·MTP on/off가 왜 옵션으로 있는가"가 저절로 설명됩니다.