테마 전환
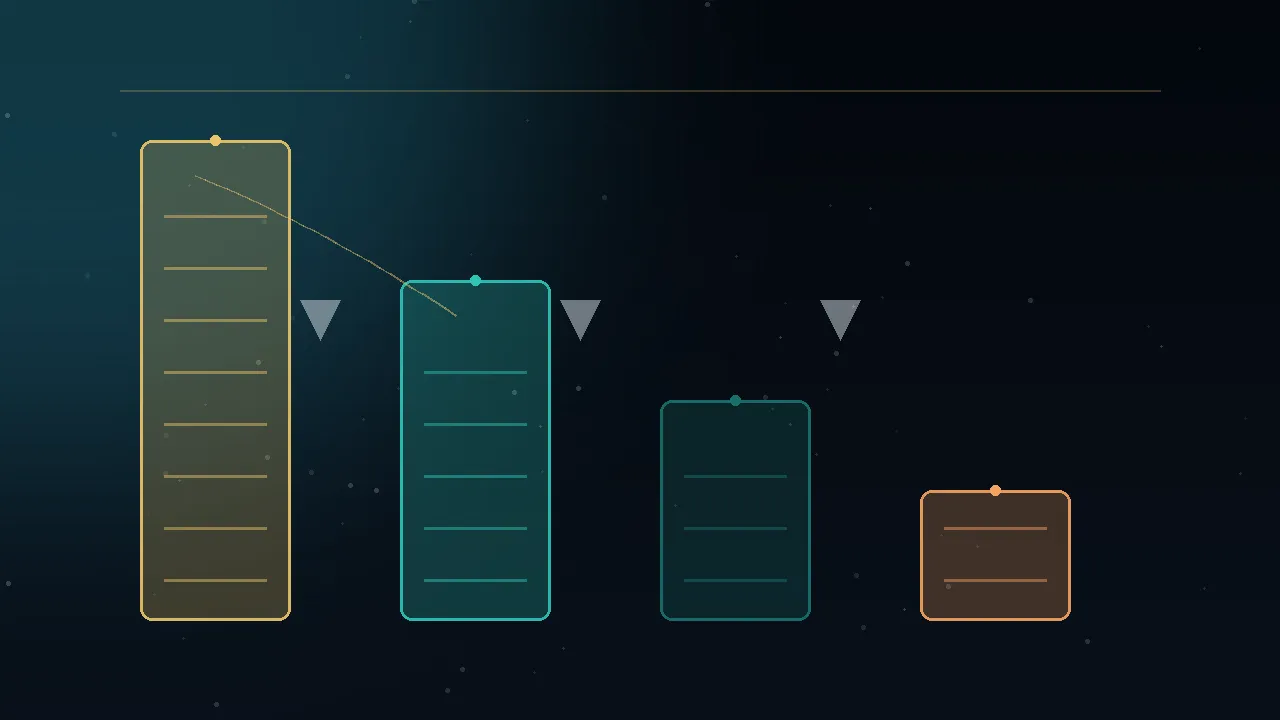
"파일이 너무 커서 AI가 읽지 못해요"는 Repomix 사용자가 가장 흔히 겪는 문제입니다. 토큰을 줄이는 방법은 다양하지만, 무작정 옵션을 켜는 것은 위험합니다. 잘못하면 AI가 분석에 꼭 필요한 핵심 로직까지 지워버릴 수 있기 때문입니다.
가장 효율적인 전략은 "가장 비용이 적고 영향이 적은 방법부터 적용하는 것"입니다.
먼저 진단: 어디서 토큰이 새는가
무작정 옵션을 적용하기 전에, 먼저 데이터의 분포를 확인하세요.
bash
repomix --token-count-tree
repomix --token-count-tree 1000 # 1000토큰 이상의 폴더만 표시--token-count-tree를 실행하면 어떤 디렉터리나 파일이 토큰을 가장 많이 잡아먹고 있는지 한눈에 보입니다. 이 진단 결과가 있어야 --include로 좁힐지, --compress로 압축할지, 아니면 --split-output으로 나눌지 결정할 수 있습니다.
1단계 좁히기: 포함과 무시 필터
가장 확실하고 부작용이 없는 방법입니다. 질문과 전혀 상관없는 파일은 애초에 제외하세요.
bash
# 1. 핵심 소스와 문서만 포함
repomix --include "src/**/*.ts,docs/**/*.md"

# 2. 테스트, 빌드 결과물, 커버리지 등 불필요한 파일 제거
repomix --ignore "**/*.test.ts,dist/**,coverage/**"

# 3. 스타일 시트와 로그까지 완전히 제거
repomix --ignore "**/*.css,**/*.test.ts,dist/**,coverage/**,*.log"
만약 전체 구조는 유지하되 내용만 빼고 싶다면 --no-files 옵션을 사용하여 요약과 트리 구조만 생성할 수 있습니다.
주의: 설정 파일 편에서 언급했듯, --include는 후보군을 좁히는 필터일 뿐입니다. 이미 무시 규칙(ignore)에 걸린 파일은 --include를 써도 제외됩니다. 강제로 넣고 싶다면 --no-gitignore나 --no-default-patterns를 함께 사용하세요.
2단계 덜어내기: 주석 제거
--remove-comments 옵션은 지원하는 언어의 주석을 제거하여 순수 코드만 남깁니다.
bash
repomix --remove-comments| 언어 | 제거 대상 |
|---|---|
| JS / TS / Java / C / C++ | //, /* */ |
| Python | #, """, ''' |
| HTML | <!-- --> |
| CSS | /* */ |
판단 기준:
- 제거 권장: 단순한 설명, 오래된 TODO, 중복된 주석이 너무 많아 토큰을 낭비할 때.
- 유지 권장: API 계약, 복잡한 비즈니스 로직의 구현 근거, 중요한 경고 메시지가 담긴 주석일 때. 이를 지우면 AI가 "왜 이렇게 짰는지"를 이해하지 못해 잘못된 제안을 할 수 있습니다.
3단계 압축: Tree-sitter 코드 압축
--compress 옵션은 Tree-sitter 파서를 사용하여 코드의 구조(시그니처)는 남기고 세부 구현부는 지웁니다.
| 남는 부분 (보존) | 사라지는 부분 (삭제) |
|---|---|
| 함수 및 메서드 이름, 파라미터, 리턴 타입 | 함수 내부의 구체적인 로직 구현부 |
| 인터페이스, 클래스 정의 및 프로퍼티 | 루프, 조건문 내부의 세부 코드 |
| import / export 문 | 내부 변수 선언 및 계산 로직 |
결과 예시: 함수 몸체가 ⋮----와 같은 마커로 대체되어, 전체적인 API 구조와 인터페이스는 유지하면서 토큰 사용량을 약 70%까지 획기적으로 줄일 수 있습니다.
⚠️ 언제 사용하는가?
- 적합한 경우: 전체적인 아키텍처 분석, 인터페이스 설계 공유, 상위 수준의 문서화, 패턴 파악.
- 부적합한 경우: 라인 단위의 정밀한 버그 수정, 로직 최적화. 구현부가 사라지면 AI가 실제로 고쳐야 할 코드를 볼 수 없기 때문입니다.
4단계 차등 적용: 파일별 포함 수준
전체 압축이 너무 과하다면, output.patterns 설정을 통해 파일마다 포함 수준을 다르게 지정하세요. (설정 파일 전용 옵션)
json5
{
  "output": {
    "compress": false, // 기본은 전체 내용 포함
    "patterns": [
      { "pattern": "docs/**/*", "compress": true }, // 문서는 압축
      { "pattern": "website/**/*", "directoryStructureOnly": true } // 웹사이트 폴더는 구조만 표시
    ]
  }
}
이 설정을 통해 "핵심 로직은 상세히, 주변부는 압축하거나 구조만" 보여주는 효율적인 컨텍스트 구성이 가능합니다.
5단계 정리: 빈 줄과 base64 처리
마지막으로 세세한 부분에서 토큰을 쥐어짜는 단계입니다.
| 옵션 | 효과 | 비고 |
|---|---|---|
--remove-empty-lines | 불필요한 빈 줄 제거 | 가독성은 약간 떨어지지만 토큰을 아낍니다. |
--truncate-base64 | 긴 base64 문자열을 절단 | 이미지 데이터 등이 포함된 파일에서 매우 효과적입니다. |
output.parsableStyle | 특수문자 이스케이프 처리 | 주의: 이 옵션은 오히려 토큰 사용량을 증가시킵니다. 파싱 안정성을 위한 선택입니다. |
최후의 수단: 분할과 예산 설정
모든 최적화를 적용해도 모델의 컨텍스트 창을 넘는다면, 이제는 나누는 전략을 써야 합니다.
1. 출력 분할 (--split-output)
bash
repomix --split-output 1mb결과물을 repomix-output.1.xml, repomix-output.2.xml 등으로 나눕니다. 이때 최상위 디렉터리 단위로 묶어서 분할하므로, 하나의 파일이 두 개로 찢어지는 일 없이 깔끔하게 나뉩니다. AI 서비스의 파일당 용량 제한을 극복하는 가장 좋은 방법입니다.
2. 토큰 예산 설정 (--token-budget)
bash
repomix --token-budget 80000출력물이 지정한 토큰 수를 넘으면 실행을 실패(exit code)로 처리합니다. CI/CD 파이프라인에서 컨텍스트 오버플로로 인해 AI 응답이 잘리는 사고를 미리 방지하는 안전장치로 활용하세요.
상황별 최적 전략 선택표
| 분석 목표 | 추천 전략 순서 | 비고 |
|---|---|---|
| 전체 아키텍처 분석 | 진단 $\rightarrow$ --compress $\rightarrow$ 분할 | 구조 파악이 우선이므로 압축이 매우 효율적 |
| 특정 버그 수정 | 진단 $\rightarrow$ --include (범위 좁히기) $\rightarrow$ 주석 제거 | 구현부의 정밀한 분석이 필요하므로 압축 금지 |
| 신규 멤버 온보딩 | 진단 $\rightarrow$ output.patterns (핵심은 상세히, 나머지는 구조만) | 중요도에 따른 차등 제공이 효과적 |
| CI/CD 자동화 | --token-budget $\rightarrow$ --token-count-tree | 안정적인 토큰 범위 유지 및 회귀 감시 |
이제 토큰 최적화까지 마스터하셨습니다. 다음 편에서는 가장 민감한 문제인 "보안 검사와 프라이버시"에 대해 알아보겠습니다.