테마 전환
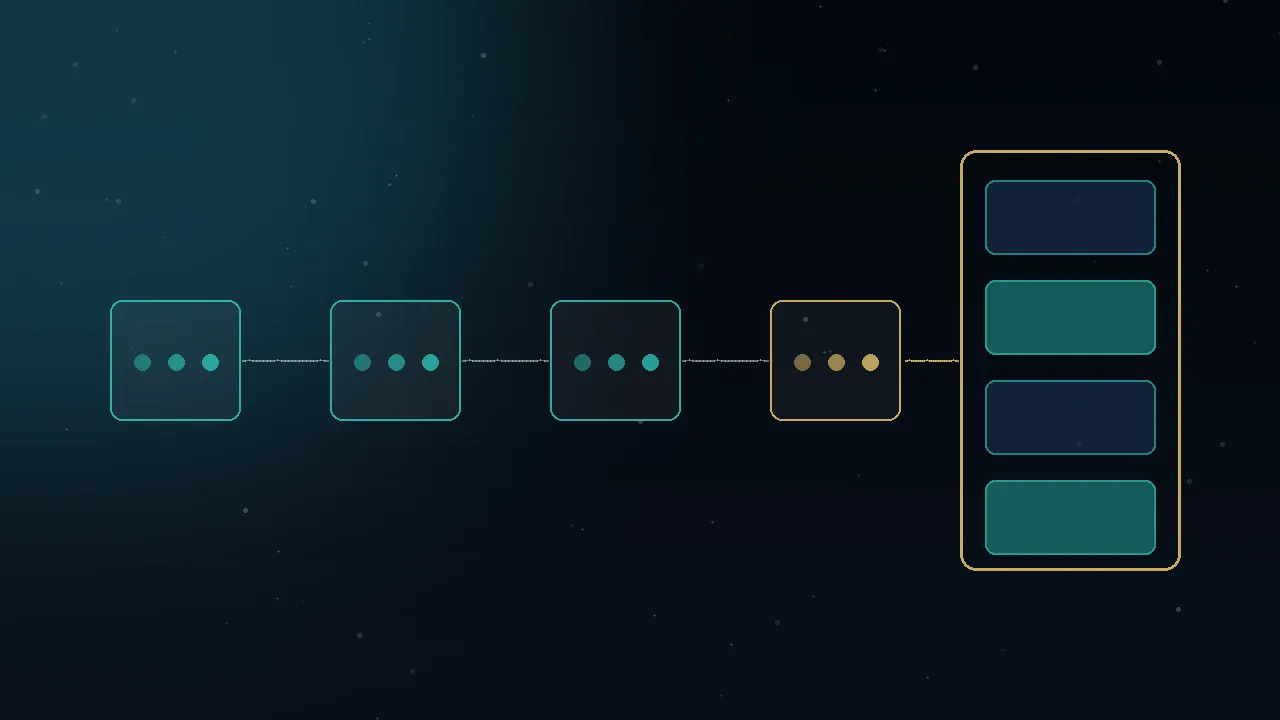
Repomix의 결과물은 단순한 텍스트 뭉치가 아닙니다. AI가 저장소를 읽을 때 "무엇을 먼저 보고, 어떻게 판단하는가"라는 흐름을 고려해 설계된 구조물입니다. 이 구조를 이해하면 어떤 옵션을 사용해야 토큰을 아끼고 정확도를 높일 수 있는지 알 수 있습니다.
처리 파이프라인 다섯 단계
Repomix가 실행되면 다음과 같은 순서로 파일을 처리합니다.
| 순서 | 단계 | 주요 결정 사항 |
|---|---|---|
| 1 | 파일 검색 | include 패턴과 ignore 규칙(.gitignore, .repomixignore 등)을 적용해 대상 파일을 선별합니다. |
| 2 | 내용 수집 | 파일 본문과 크기를 읽습니다. 설정된 최대 파일 크기(input.maxFileSize, 기본 50MB)를 넘는 파일은 제외됩니다. |
| 3 | 전처리 | 외부 명령(input.processors)을 통한 변환, 주석 및 빈 줄 제거, Tree-sitter 기반 코드 압축을 적용합니다. |
| 4 | 보안 검사 | Secretlint를 사용해 API 키, 토큰, 비밀번호 같은 민감 정보가 포함된 파일을 찾아냅니다. |
| 5 | 토큰 계산 및 출력 | 인코더로 토큰 수를 세고, 선택한 포맷(XML, JSON 등)에 맞춰 네 가지 블록으로 조립해 저장합니다. |
여기서 중요한 점은 전처리(3단계)가 보안 검사(4단계)보다 먼저 일어난다는 것입니다. 즉, 주석을 제거하거나 코드를 압축한 뒤의 최종 내용을 바탕으로 보안 검사를 수행하므로, 전처리 과정에서 의도치 않게 생성된 민감 정보까지 잡아낼 수 있습니다.
출력 파일을 이루는 네 블록
가장 권장되는 XML 포맷을 기준으로, 결과 파일은 크게 네 개의 블록으로 구성됩니다.
xml
<!-- 파일 상단: AI를 위한 기본 안내문 -->

<file_summary>
(전체 규모 및 메타데이터)
</file_summary>

<directory_structure>
src/
  index.ts
  utils/
    helper.ts
</directory_structure>

<files>
<file path="src/index.ts">
// 실제 파일 내용
</file>
</files>

<git_logs>
2025-08-20 00:47:19 +0900|feat(cli): Add --include-logs option for git commit history
README.md
src/cli/cliRun.ts
</git_logs>
각 블록은 옵션을 통해 켜고 끌 수 있습니다. (--no-file-summary, --no-directory-structure, --no-files 등) 또한 사용자 정의 헤더(output.headerText)나 별도의 지침 파일(output.instructionFilePath)을 통해 AI에게 특별한 가이드라인을 제공하는 <instruction> 블록을 추가할 수 있습니다.
파일 요약 블록: 규모를 먼저 파악한다
<file_summary> 블록에는 총 파일 개수, 전체 문자 수, 토큰 수, 그리고 가장 큰 파일 목록이 담깁니다. 이는 AI에게 "지금부터 읽을 데이터의 규모와 복잡도"를 먼저 알려주어, AI가 더 효율적인 추론 전략을 세우도록 돕는 역할을 합니다.
토큰 계산은 기본적으로 o200k_base(GPT-4o 계열) 인코더를 사용하며, 필요에 따라 cl100k_base 등으로 변경할 수 있습니다. 이 수치는 절대적인 값이라기보다, 사용 중인 AI 모델의 컨텍스트 한도 내에 들어오는지를 가늠하는 척도로 활용하세요.
디렉터리 구조 블록과 바이너리 파일
<directory_structure>는 프로젝트의 전체 트리를 보여줍니다. 이때 바이너리 파일의 처리 방식에 주목해야 합니다.
- 본문 제외: 이미지, PDF, 컴파일된 바이너리, 압축 파일 등은 텍스트 기반 출력을 유지하고 AI 처리 효율을 높이기 위해 내용을 포함하지 않습니다.
- 경로 유지: 본문은 제외되지만, 파일의 존재 여부(경로)는 트리 목록에 표시됩니다. AI는
logo.png나app.jar가 프로젝트에 존재한다는 사실은 알 수 있지만, 그 내부 바이트 데이터는 읽지 못합니다.
또한, --include 옵션으로 특정 파일만 좁게 선택했더라도 output.includeFullDirectoryStructure 옵션을 켜면 전체 디렉터리 구조를 그대로 보여줄 수 있습니다. 이는 AI가 선택된 파일들이 전체 구조 속에서 어디에 위치하는지 파악하게 하여 분석 정확도를 높여줍니다.
파일 내용 블록과 경로 표기
<files> 블록은 실제 파일 경로와 본문이 쌍을 이루어 나열되는 핵심 구간입니다.
| 설정 항목 | 설명 |
|---|---|
filePathStyle | 경로 표기 방식 결정. target-relative(기본)는 지정한 루트 기준, cwd-relative는 현재 작업 디렉터리 기준으로 표기합니다. |
showLineNumbers | 각 줄에 번호를 부여합니다. AI가 "N행의 코드를 수정하라"고 구체적으로 지칭하게 만들 때 매우 유용합니다. |
parsableStyle | 특수문자를 이스케이프 처리하여 포맷 파손을 막습니다. 안정성은 높아지지만 토큰 사용량이 약간 늘어납니다. |
| 토큰 절감 옵션 | removeComments(주석 제거), removeEmptyLines(빈 줄 제거) 등을 통해 컨텍스트 비용을 줄일 수 있습니다. |
깃 정보: 정렬, diff, 커밋 로그
Repomix는 단순히 파일을 합치는 것을 넘어 Git의 맥락을 이해하는 도구입니다.
- 변경 기반 정렬 (
sortByChanges): 변경 횟수가 많은 파일일수록 아래쪽에 배치하여, AI가 가장 최근까지 활발하게 수정된 코드를 나중에(더 가깝게) 읽도록 유도합니다. - 변경 사항 포함 (
includeDiffs): 현재 작업 트리와 스테이징 영역의 변경 내용을 별도 블록으로 추가합니다. "지금 무엇을 수정 중인가"를 AI에게 알리는 가장 확실한 방법입니다. - 커밋 로그 포함 (
includeLogs): 최근 커밋 메시지와 변경 파일 목록을 추가하여, 개발의 흐름과 현재의 초점을 전달합니다.
이런 정보들이 결합되면 AI는 단순한 코드 분석을 넘어, "이 개발자가 최근에 어떤 고민을 하며 코드를 고쳐왔는가"라는 동적인 컨텍스트까지 파악할 수 있게 됩니다.
내용 없이 구조만 미리 보는 방법
저장소가 너무 커서 무엇을 포함할지 결정하기 어렵다면, 본문을 제외하고 구조만 먼저 확인해 보세요.
bash
# 파일 내용 없이 요약과 트리만 출력
repomix --no-files

# 디렉터리별 토큰 사용량 분포 확인
repomix --token-count-tree
repomix --token-count-tree 1000 # 1000토큰 이상의 폴더만 표시--token-count-tree를 통해 토큰이 집중된 지점을 찾고 $\rightarrow$ --include와 --ignore로 대상을 좁히며 $\rightarrow$ 필요 시 압축이나 분할 옵션을 적용하는 것이 가장 효율적인 워크플로입니다.
이제 동작 원리를 이해했으니, 다음 편에서는 실제로 설치해서 첫 결과물을 만들어 보겠습니다.